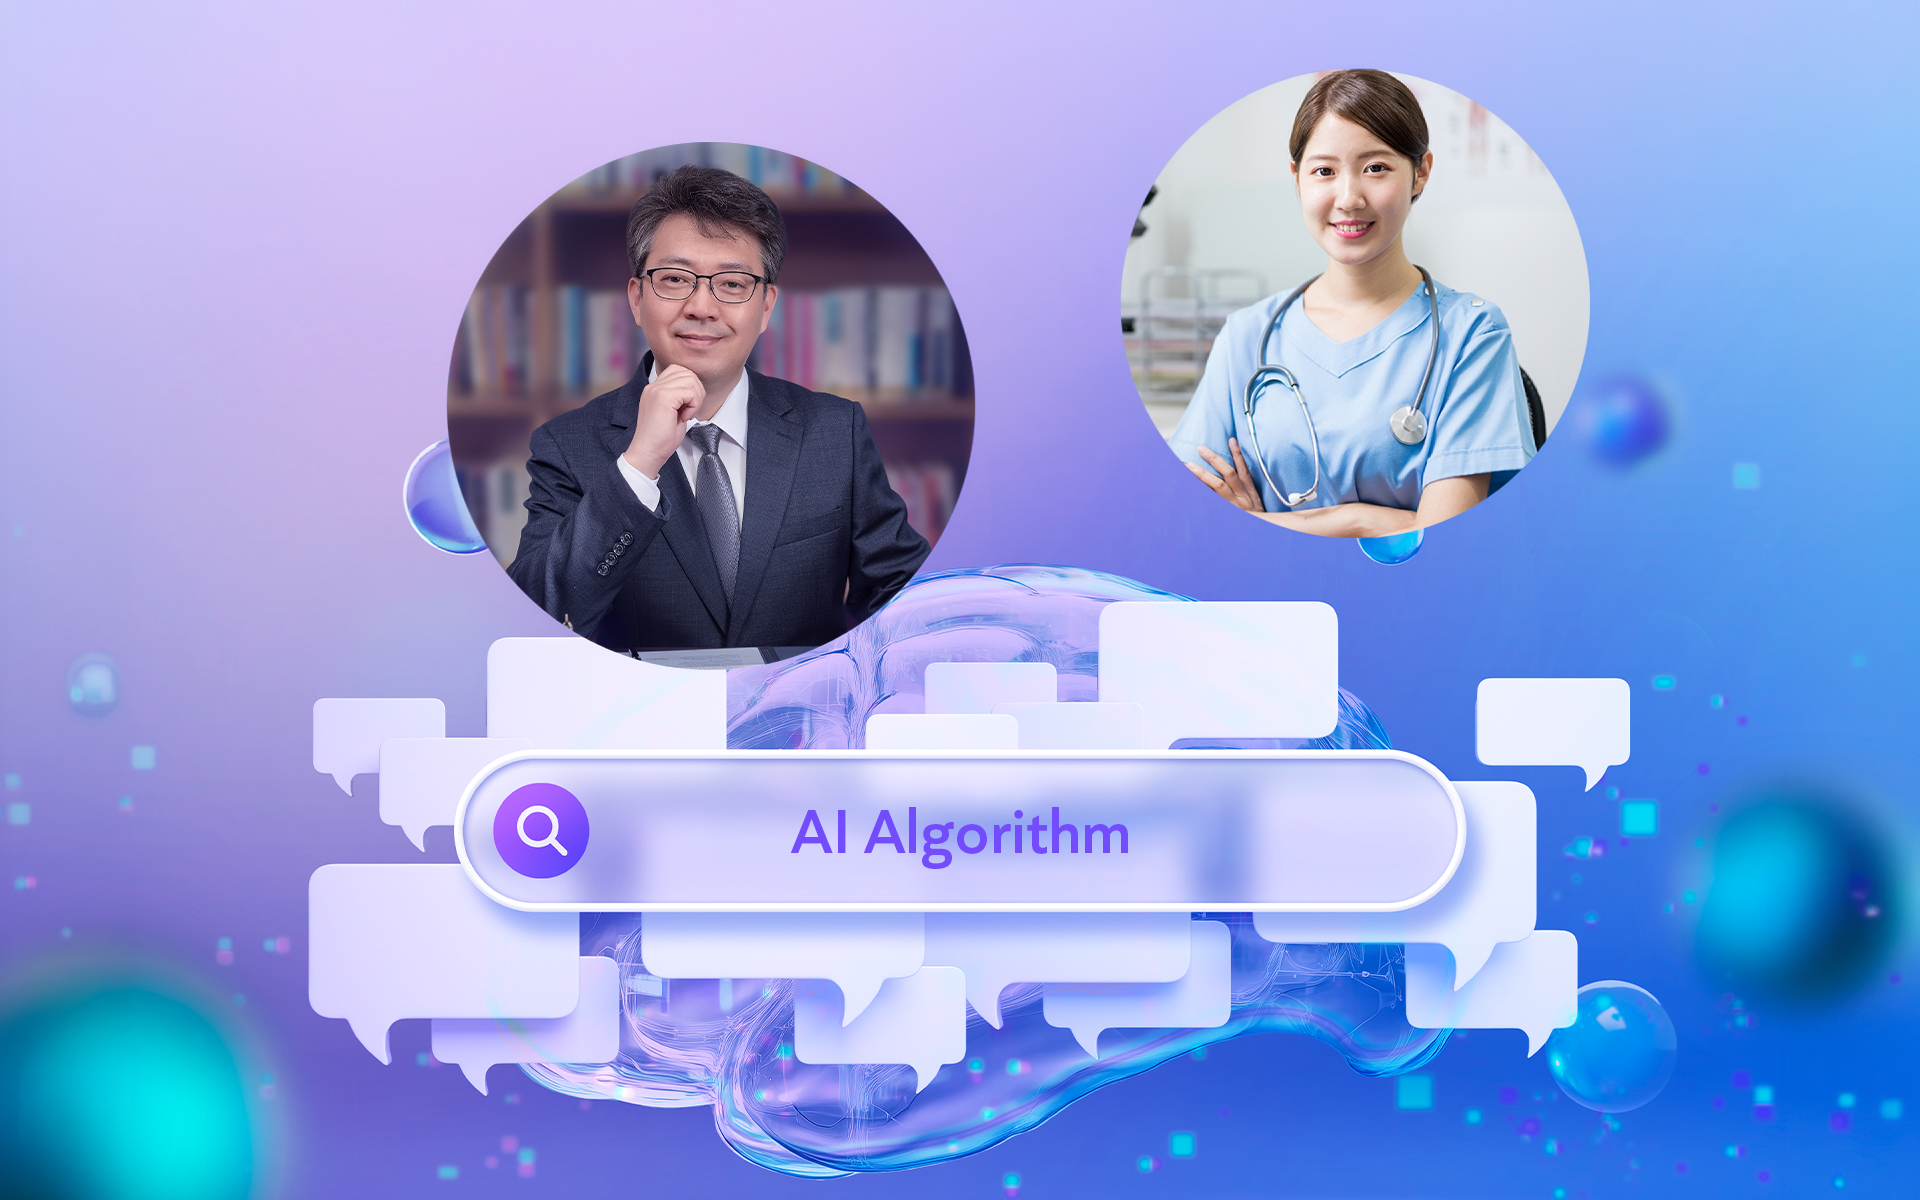
과거 Google 이미지 검색에서 “CEO”, “engineer”, “scientist”와 같은 키워드를 입력하면 대부분 남성 사진이 상위에 노출되는 현상이 보고된 바 있다. 반대로 “nurse”, “teacher” 같은 직업을 검색하면 여성 이미지가 과도하게 많이 나타났다.
이는 구글이 의도적으로 성별을 차별한 것이 아니라, 인터넷에 존재하는 이미지와 캡션 데이터를 학습한 결과 기존 사회의 직업 성별 분포가 그대로 검색 결과에 반영된 것으로 분석되었다.
인터넷 검색 시 성별 차별은 인공지능의 알고리즘과 사회적 편견의 영향을 받게 된다. AI가 만든 직업 사진에서의 성별 편향은, DALL-E 3, Emu, Stable Diffusion XL, Stable Cascade 등 다양한 AI 모델이 직업을 묘사할 때 성별 고착관념을 재생산하는 통계적 현상이다. 이러한 편향은 AI가 직업과 성별을 어떻게 연관짓는지를 확인하는 사회적으로 중요한 문제이며, 알고리즘이 중립적으로 보이더라도 실제로는 사회적 고정관념을 증폭할 수 있음을 보여주는 대표적인 사례로 자주 인용된다.
이렇게 인공지능이 기업과 공공 영역의 의사결정에 깊숙이 관여하기 시작하면서, 새로운 질문이 등장했다.
“AI가 내린 결정에 대해 누가 책임지는가?”
이 질문에 대한 답을 찾는 과정에서 등장한 개념이 바로 알고리즘 책임성이다.
알고리즘은 정말 중립적인가?
알고리즘은 흔히 객관적이고 중립적인 기술로 여겨진다. 그러나 실제로는 사람이 설계한 규칙과 과거 데이터를 기반으로 작동하기 때문에, 사회적 편향이나 구조적 불평등을 그대로 학습하고 재생산할 수 있다. 이로 인해 알고리즘이 만들어낸 결과 역시 사회적 책임의 대상이 되어야 한다는 논의가 확산되고 있다.
알고리즘 책임성은 이러한 문제의식에서 출발한 개념으로, 알고리즘이 만들어낸 의사결정 과정과 결과에 대해 조직이 설명 가능하고, 필요할 경우 책임을 질 수 있어야 한다는 원칙을 의미한다.
사례 1. 알고리즘은 여성 지원자를 걸러낸다? AI 채용 도입이 불러온 예상 밖의 차별
한 글로벌 IT 기업은 수천 건의 이력서를 자동으로 평가하기 위해 AI 기반 채용 추천 시스템을 도입했다. 이 시스템은 과거 채용 데이터를 학습해 ‘우수 인재의 특징’을 자동으로 찾아내도록 설계되어 있었다. 그러나 운영 과정에서 한 가지 문제가 발견되었다. AI가 여성 지원자의 이력서를 체계적으로 낮게 평가하고 있었던 것이다.
알고 보니 과거 수년간의 채용 데이터가 남성 중심으로 구성되어 있었고, AI는 이를 ‘성공적인 채용 패턴’으로 학습해 여성 지원자를 불리하게 평가하는 방향으로 작동하고 있었다. 기업은 결국 해당 시스템을 폐기했지만, 이 사건은 AI가 객관적일 것이라는 믿음에 큰 균열을 남겼다.
이 사례는 알고리즘이 기술적으로 오류가 없더라도, 학습 데이터의 편향만으로도 차별적 결과를 만들어낼 수 있음을 보여준다.
사례 2. AI 대출 심사가 드러낸 보이지 않는 차별, 알고리즘이 신용을 판단할 때
한 금융기관은 대출 심사의 효율성과 일관성을 높이기 위해 AI 기반 신용평가 시스템을 도입했다. 이 시스템은 고객의 소득, 거래 이력, 소비 패턴 등 다양한 데이터를 분석해 대출 가능 여부와 금리를 자동으로 산정했다.
그러나 운영 이후 특정 지역 거주자와 사회경제적 취약 계층의 대출 승인율이 현저히 낮게 나타난다는 사실이 확인되었다. 금융기관은 민감한 개인 정보를 직접 사용하지 않았다고 설명했지만, AI는 우편번호나 소비 패턴과 같은 간접 지표를 통해 고객의 배경을 추정하고 이를 신용 위험으로 판단하고 있었다.
결과적으로 이 시스템은 기존 사회의 불평등 구조를 그대로 반영하며, 대출 심사 과정에서 새로운 형태의 차별을 만들어내고 있었다.
채용과 금융이라는 서로 다른 영역의 사례는 공통적으로, 알고리즘이 단순히 판단을 자동화하는 도구가 아니라 기존 사회 구조를 학습하고 재생산하는 체계임을 보여준다.
ESG 시대의 새로운 거버넌스 이슈
이러한 문제는 기술적 논의를 넘어 기업 지배구조의 문제로 확장되고 있다. 기업이 어떤 알고리즘을 사용하고 있는지, 그 알고리즘이 어떤 기준으로 의사결정을 내리는지, 그리고 문제가 발생했을 때 이를 수정하고 책임질 수 있는 통제 체계가 마련되어 있는지는 이제 기업 거버넌스를 평가하는 중요한 요소가 되고 있다.
과거 ESG 논의에서 거버넌스는 주로 이사회 구성이나 내부통제 체계에 초점을 맞췄다면, 이제는 알고리즘과 데이터의 통제 방식까지 포함하는 방향으로 확장되고 있다.
기술의 문제가 아니라 책임의 문제: 설명 가능한 AI, 책임 가능한 조직
알고리즘 책임성을 실현하기 위해서는 ‘설명 가능성’이 중요한 전제 조건이 된다. AI가 왜 특정한 결정을 내렸는지 조직이 이해하고 설명할 수 있어야만, 그 결과에 대한 책임 역시 논의할 수 있기 때문이다.
하지만 현실에서는 많은 AI 시스템이 복잡한 통계 모델과 대규모 데이터에 기반해 작동하기 때문에, 의사결정 과정을 사람이 직관적으로 이해하기 어려운 경우가 많다. 이 때문에 최근에는 AI 시스템의 작동 원리와 의사결정 기준을 문서화하고, 외부 감사나 검증을 받는 등의 관리 체계가 점차 도입되고 있다.
알고리즘 책임성은 인공지능의 성능을 평가하는 개념이 아니라, 그 기술이 사회 속에서 어떻게 사용되고 통제되는지를 묻는 개념이다. 다시 말해, “AI가 얼마나 정확한가”가 아니라 “AI가 내린 결정에 대해 조직이 어떤 책임을 지는가”를 묻는 질문이다.
AI가 기업 활동의 핵심 도구로 자리 잡아 가는 지금, 알고리즘 책임성은 단순한 기술 윤리를 넘어 조직의 책임성과 투명성을 판단하는 새로운 기준으로 자리 잡고 있다. 앞으로 기업이 무엇을 생산하는가뿐 아니라, 어떤 알고리즘으로 의사결정을 내리는가까지 설명해야 하는 시대가 도래하고 있다.


과거 Google 이미지 검색에서 “CEO”, “engineer”, “scientist”와 같은 키워드를 입력하면 대부분 남성 사진이 상위에 노출되는 현상이 보고된 바 있다. 반대로 “nurse”, “teacher” 같은 직업을 검색하면 여성 이미지가 과도하게 많이 나타났다.
이는 구글이 의도적으로 성별을 차별한 것이 아니라, 인터넷에 존재하는 이미지와 캡션 데이터를 학습한 결과 기존 사회의 직업 성별 분포가 그대로 검색 결과에 반영된 것으로 분석되었다.
인터넷 검색 시 성별 차별은 인공지능의 알고리즘과 사회적 편견의 영향을 받게 된다. AI가 만든 직업 사진에서의 성별 편향은, DALL-E 3, Emu, Stable Diffusion XL, Stable Cascade 등 다양한 AI 모델이 직업을 묘사할 때 성별 고착관념을 재생산하는 통계적 현상이다. 이러한 편향은 AI가 직업과 성별을 어떻게 연관짓는지를 확인하는 사회적으로 중요한 문제이며, 알고리즘이 중립적으로 보이더라도 실제로는 사회적 고정관념을 증폭할 수 있음을 보여주는 대표적인 사례로 자주 인용된다.
이렇게 인공지능이 기업과 공공 영역의 의사결정에 깊숙이 관여하기 시작하면서, 새로운 질문이 등장했다.
“AI가 내린 결정에 대해 누가 책임지는가?”
이 질문에 대한 답을 찾는 과정에서 등장한 개념이 바로 알고리즘 책임성이다.
알고리즘은 정말 중립적인가?
알고리즘은 흔히 객관적이고 중립적인 기술로 여겨진다. 그러나 실제로는 사람이 설계한 규칙과 과거 데이터를 기반으로 작동하기 때문에, 사회적 편향이나 구조적 불평등을 그대로 학습하고 재생산할 수 있다. 이로 인해 알고리즘이 만들어낸 결과 역시 사회적 책임의 대상이 되어야 한다는 논의가 확산되고 있다.
알고리즘 책임성은 이러한 문제의식에서 출발한 개념으로, 알고리즘이 만들어낸 의사결정 과정과 결과에 대해 조직이 설명 가능하고, 필요할 경우 책임을 질 수 있어야 한다는 원칙을 의미한다.
사례 1. 알고리즘은 여성 지원자를 걸러낸다? AI 채용 도입이 불러온 예상 밖의 차별
한 글로벌 IT 기업은 수천 건의 이력서를 자동으로 평가하기 위해 AI 기반 채용 추천 시스템을 도입했다. 이 시스템은 과거 채용 데이터를 학습해 ‘우수 인재의 특징’을 자동으로 찾아내도록 설계되어 있었다. 그러나 운영 과정에서 한 가지 문제가 발견되었다. AI가 여성 지원자의 이력서를 체계적으로 낮게 평가하고 있었던 것이다.
알고 보니 과거 수년간의 채용 데이터가 남성 중심으로 구성되어 있었고, AI는 이를 ‘성공적인 채용 패턴’으로 학습해 여성 지원자를 불리하게 평가하는 방향으로 작동하고 있었다. 기업은 결국 해당 시스템을 폐기했지만, 이 사건은 AI가 객관적일 것이라는 믿음에 큰 균열을 남겼다.
이 사례는 알고리즘이 기술적으로 오류가 없더라도, 학습 데이터의 편향만으로도 차별적 결과를 만들어낼 수 있음을 보여준다.
사례 2. AI 대출 심사가 드러낸 보이지 않는 차별, 알고리즘이 신용을 판단할 때
한 금융기관은 대출 심사의 효율성과 일관성을 높이기 위해 AI 기반 신용평가 시스템을 도입했다. 이 시스템은 고객의 소득, 거래 이력, 소비 패턴 등 다양한 데이터를 분석해 대출 가능 여부와 금리를 자동으로 산정했다.
그러나 운영 이후 특정 지역 거주자와 사회경제적 취약 계층의 대출 승인율이 현저히 낮게 나타난다는 사실이 확인되었다. 금융기관은 민감한 개인 정보를 직접 사용하지 않았다고 설명했지만, AI는 우편번호나 소비 패턴과 같은 간접 지표를 통해 고객의 배경을 추정하고 이를 신용 위험으로 판단하고 있었다.
결과적으로 이 시스템은 기존 사회의 불평등 구조를 그대로 반영하며, 대출 심사 과정에서 새로운 형태의 차별을 만들어내고 있었다.
채용과 금융이라는 서로 다른 영역의 사례는 공통적으로, 알고리즘이 단순히 판단을 자동화하는 도구가 아니라 기존 사회 구조를 학습하고 재생산하는 체계임을 보여준다.
ESG 시대의 새로운 거버넌스 이슈
이러한 문제는 기술적 논의를 넘어 기업 지배구조의 문제로 확장되고 있다. 기업이 어떤 알고리즘을 사용하고 있는지, 그 알고리즘이 어떤 기준으로 의사결정을 내리는지, 그리고 문제가 발생했을 때 이를 수정하고 책임질 수 있는 통제 체계가 마련되어 있는지는 이제 기업 거버넌스를 평가하는 중요한 요소가 되고 있다.
과거 ESG 논의에서 거버넌스는 주로 이사회 구성이나 내부통제 체계에 초점을 맞췄다면, 이제는 알고리즘과 데이터의 통제 방식까지 포함하는 방향으로 확장되고 있다.
기술의 문제가 아니라 책임의 문제: 설명 가능한 AI, 책임 가능한 조직
알고리즘 책임성을 실현하기 위해서는 ‘설명 가능성’이 중요한 전제 조건이 된다. AI가 왜 특정한 결정을 내렸는지 조직이 이해하고 설명할 수 있어야만, 그 결과에 대한 책임 역시 논의할 수 있기 때문이다.
하지만 현실에서는 많은 AI 시스템이 복잡한 통계 모델과 대규모 데이터에 기반해 작동하기 때문에, 의사결정 과정을 사람이 직관적으로 이해하기 어려운 경우가 많다. 이 때문에 최근에는 AI 시스템의 작동 원리와 의사결정 기준을 문서화하고, 외부 감사나 검증을 받는 등의 관리 체계가 점차 도입되고 있다.
알고리즘 책임성은 인공지능의 성능을 평가하는 개념이 아니라, 그 기술이 사회 속에서 어떻게 사용되고 통제되는지를 묻는 개념이다. 다시 말해, “AI가 얼마나 정확한가”가 아니라 “AI가 내린 결정에 대해 조직이 어떤 책임을 지는가”를 묻는 질문이다.
AI가 기업 활동의 핵심 도구로 자리 잡아 가는 지금, 알고리즘 책임성은 단순한 기술 윤리를 넘어 조직의 책임성과 투명성을 판단하는 새로운 기준으로 자리 잡고 있다. 앞으로 기업이 무엇을 생산하는가뿐 아니라, 어떤 알고리즘으로 의사결정을 내리는가까지 설명해야 하는 시대가 도래하고 있다.